> For the complete documentation index, see [llms.txt](https://docs.vocu.ai/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.vocu.ai/zh/generate/config.md).
# 生成配置
在此处了解您可以调整哪些选项来影响生成结果
在完成内容编辑后,您可以在功能区点击齿轮图标进行生成配置的调整。
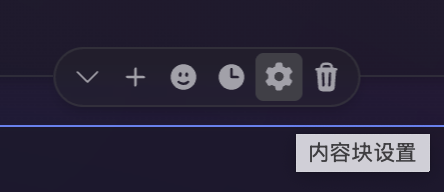 (移动端同样为齿轮图标)
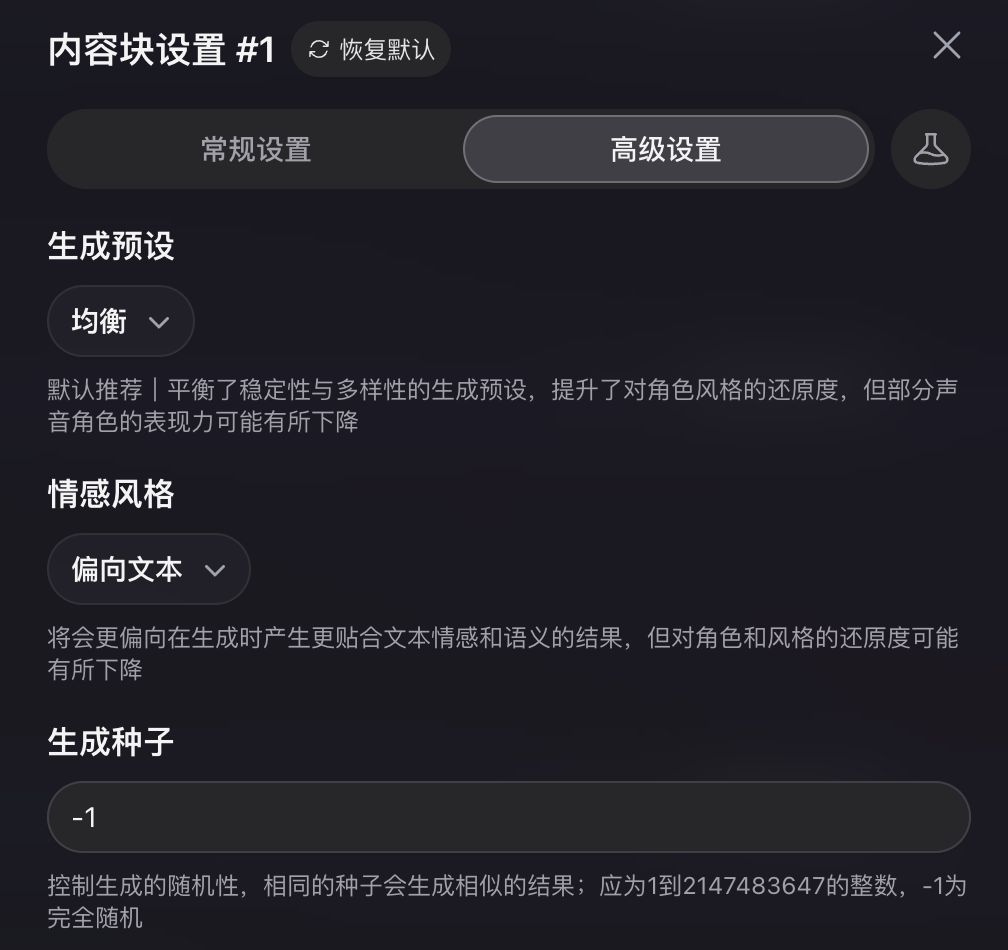
**生成参数**对于最终生成的效果会有很大影响,目前我们基于多方测试和优化,设置了不同的预设模板,分别对应不同的优化方向,您可以通过调整预设来选择不同的生成参数,以找到对于您来说最合适的效果。
 {% hint style="info" %}
我们准备的生成预设参数能够应对大多数情况下的文本和音色内容,您可以先尝试使用默认参数进行生成,如果多次切换预设效果仍未达到预期,您可尝试使用官方角色测试是否为声音角色的样本不佳导致。您也可以联系我们的支持服务以获得帮助。
{% endhint %}
可手动调整的生成设置
* **生成预设:**用于控制语音在生成时采用的表现策略,决定语音在听感上的基础表现力。不同的生成预设侧重不同的参数方向,能够决定输出语音与文本之间的理解表现力(例如,使用均衡预设,语音将平衡发音表现和文本理解的表现,贴合内容的理解,而使用创意类预设,语音将基于文本的语境,展现出更具有表演色彩的发音方式,在应对不同场景时会有较为独特的效果。)
* **情感风格:**针对生成时输入的内容,不同的风格偏向将在处理时优化理解和还原不同的细节部分,选择偏向文本时,将根据输入文本的语义完善结果细节,更符合文本语境;选择偏向角色时,将更注重还原声音角色样本的直接表现力。
* **生成种子**:控制生成时的随机性,相同的种子会在生成时产生相似的结果,这个值可由 1至 2147483647 的整数。默认设置为-1 时完全随机。通常不需要调整。
* **语速**:控制生成语音的速度,值越大,语速越快,可调整为0.5x到2x之间的数值,1为正常语速
V3.0 系列模型新增的独特配置
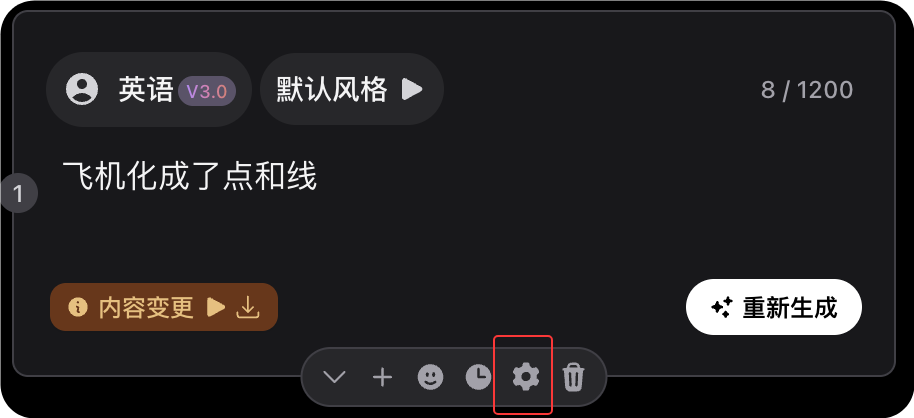 **在 V3.0 系列模型中,我们新增了一些独特参数,分配有 V3.0 模型角色的段落将可额外控制以下设置:**
* **语言选择:**指定段落中内容的语言。默认情况下系统可自动识别输入内容的语言,如出现识别不够精准的情况或您输入的语言为粤语时,请手动选择语言。(目前暂时无法自动识别粤语内容)
* **生动表达:**支持为单个段落单独启用“生动表达”选项。启用后,模型将基于对内容的理解拓展表现范围,使语句更具表现力和感染力(对日语ASMR效果最佳),但可能降低生成稳定性。
* **情感比例:**这一功能参数能够让您调节段落发音的情感倾向,启用该功能后,您可手动指定情感比例,包括生气、开心、中立、难过、匹配上下文几种,模型将根据设置的比例尝试以对应情感表现进行发音,具体效果因不同样本可能区别较大,且可能降低生成稳定性。
* **一致性优化**:**实验功能**,启用后将优化汇集在单个段落中的长篇内容生成效果,提升一致性与连贯性,但可能降低表现力。对于文本内容的编辑,可参见[文本内容编辑](https://docs.vocu.ai/zh/~/revisions/UXeoxR8p2d7pY0hBgCpM/generate/text-edit)进行了解。
* **后处理模式:实验功能,**该项目控制输出优化策略,默认将针对角色声音的还原度进行优化。此外,不同的选项可调节最终音频的听感表现,您可根据需要来尝试调整此项设置。
在参数设置完毕后关闭配置弹窗,只需点击功能区的**开始生成**按钮即可提交语音生成任务,任务提交完毕后,系统将会开始生成任务,您可在主要界面观看生成进度,并在完成后开始播放。